
之前有朋友说:AI 起的名字不错,但总感觉心里没底,它真是给我起的吗? 这个问题引起了我的兴趣,于是投入巨资(略超 100 元),对这个问题进行了研究。
研究方法
要判断一个名字是为你而起的,还是大家都一样,其实方法很简单。选一个出生日期,提一个要求,比如:名字好听、好记。然后重点来了:换不同姓氏,分别让 AI 推荐名字。还要选择不同AI,看看不同 AI 间有没有区别。 经过考虑,我们选择了目前能力最强的 claude、GPT、Gemini、Grok、DeepSeek、千问、Mistral和 GLM,以及专门为起名定制的圆桌起名等 8 个模型,用同一个需求:女宝、用神水、喜神金,要求名字好听、好记,然后姓氏选择了:林、王、李、陈、江、阮、靳、欧阳等 8 个姓氏,分别调用,每轮给出 10 个名字,直至名字中 80% 以上重复为止。 最终花费略超 100 元的巨资,得到 10000+名字后,得出最终结论。
研究成果一:AI的名字库范围有限
同一个姓氏,同样的要求,如果连续让模型起名,大部分模型如 Qwen、DeepSeek、GLM 等,会在第 9 轮左右达到上限。也就是 600-700 个名字左右,平均到每个姓氏,名字库大约就是 100 个左右的规模。 表现较好的圆桌起名、Grok 和 Mistral 可以针对同一需求,推荐 1400 个以上不重名的名字,当然这还没有达到其能力的上限。只是考虑 token 成本,不得不停止。
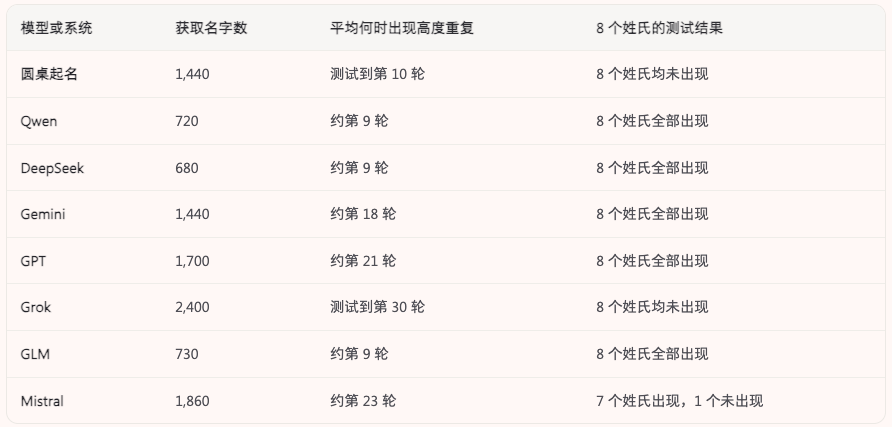
当然,这并不是说,大模型能起的名字只有这么多。只是如果你的要求不变,它能给的推荐就是这么多,剩下的就是重复而已。

研究成果二:不同姓氏间重名比例相对较高
还是继续说刚刚的实验,既然是 8 个姓氏分别起名,那么推荐给李家的名字还会给王家吗? 答案是肯定的。
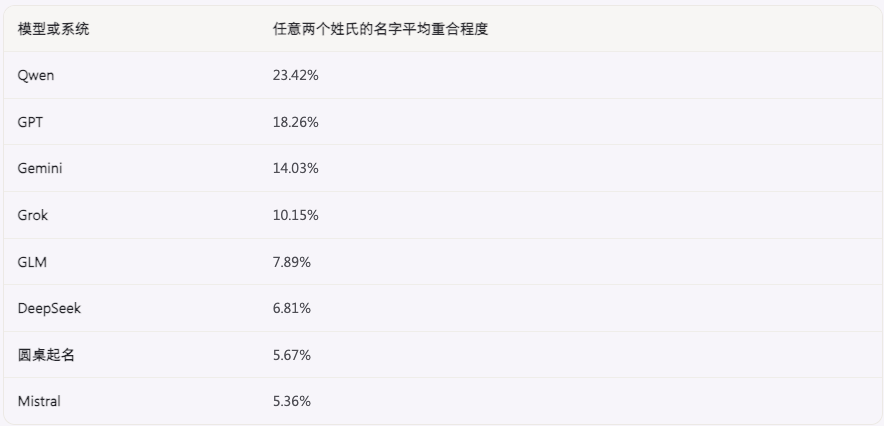
表现较差的 Qwen、GPT、Gemini、Grok 等达到了 10%以上的重名率,也就是十分之一的名字会推荐给两个以上的姓氏。其中 Qwen 更是达到了 23.4%,也就是五分之一的名字会被推荐给两个以上的姓氏。 表现较好的是 GLM、DeepSeek、圆桌起名和 Mistral,大约是二十分之一的比例。 这一现象说明,AI 推荐的名字在不同姓氏间重名的概率较高,这也许就是下一轮网红名产生的温床也说不定。
研究成果三:AI有明确的用字偏好
在同一起名条件下,AI 推荐的名字重复的比较多。如果更换条件,尤其是不同的五行喜用条件下呢?为此,我们抽取了部分模型,变换五行要求后,再次起名,结果发现:相同姓氏,不同五行,AI 起名的相似度大幅下降,但部分用字的比例依然很高。
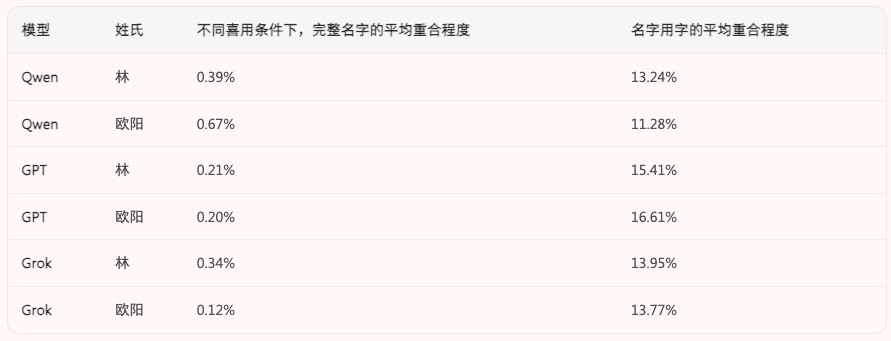
AI 最常用的字包括:汐、涵、清、昕、晴、钰、瑶等。 如果我们仔细观察,就会发现他们都是读起来好听、含义比较美好,而且符合五行偏好的字,这估计也是大部分父母共同的起名诉求吧。
研究成果四:AI 起名的出处不能全信
除了好听、好记、契合五行之外,部分家长可能还对名字的出处有一定要求,而 AI 肯定会贴心的满足这一要求。但是这些出处可信吗? 从抽查结果来看,只有不到 50% 的可信度。
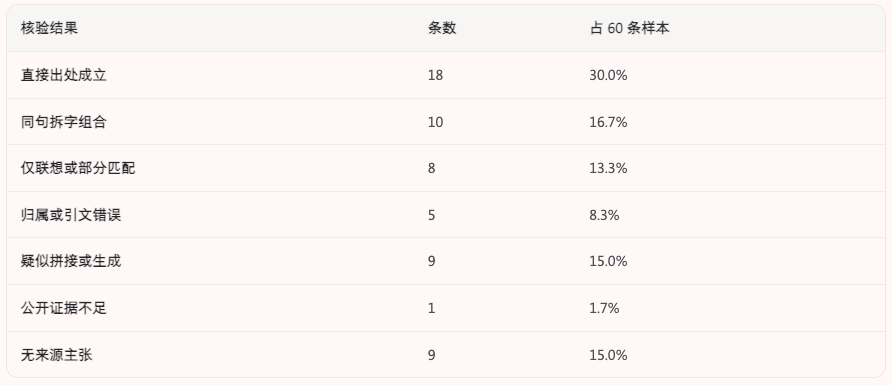
其中,直接出处成立的,占据 30%;同句拆字的,占到 16.7%;剩下的就是部分匹配,甚至随便联想的。所以,AI 给出的名字出处只能作为「参考」,真正的出处还是要自己查查才算数。
总而言之,AI 起名的局限性还是很强的。如果只是浅尝辄止,AI 起的名字大部分还是能让人满意的。但是如果考虑到减少重名、避免网红名,以及名字出处准确,那么就要慎重考虑了。多换几个 AI,以及深入追问,让 AI 辅助思考,而非完全依赖 AI 可能是更好的方案。
以上就是我们这次 AI 起名实验的全部内容了,如果你对详细测试有兴趣,欢迎点击下方的「阅读原文」进行了解。
